Lab에서 다운로드한 모델 서빙하기
Jupyter Lab에서 Hugging Face 모델을 직접 다운로드하고, 다운로드된 파일을 Model Artifacts에 등록한 뒤 Serving으로 배포합니다. 다운로드 스크립트를 직접 실행하거나 모델 파일을 수정한 뒤 등록해야 할 때 사용합니다.
사전 조건
1. Lab에 Volume 마운트
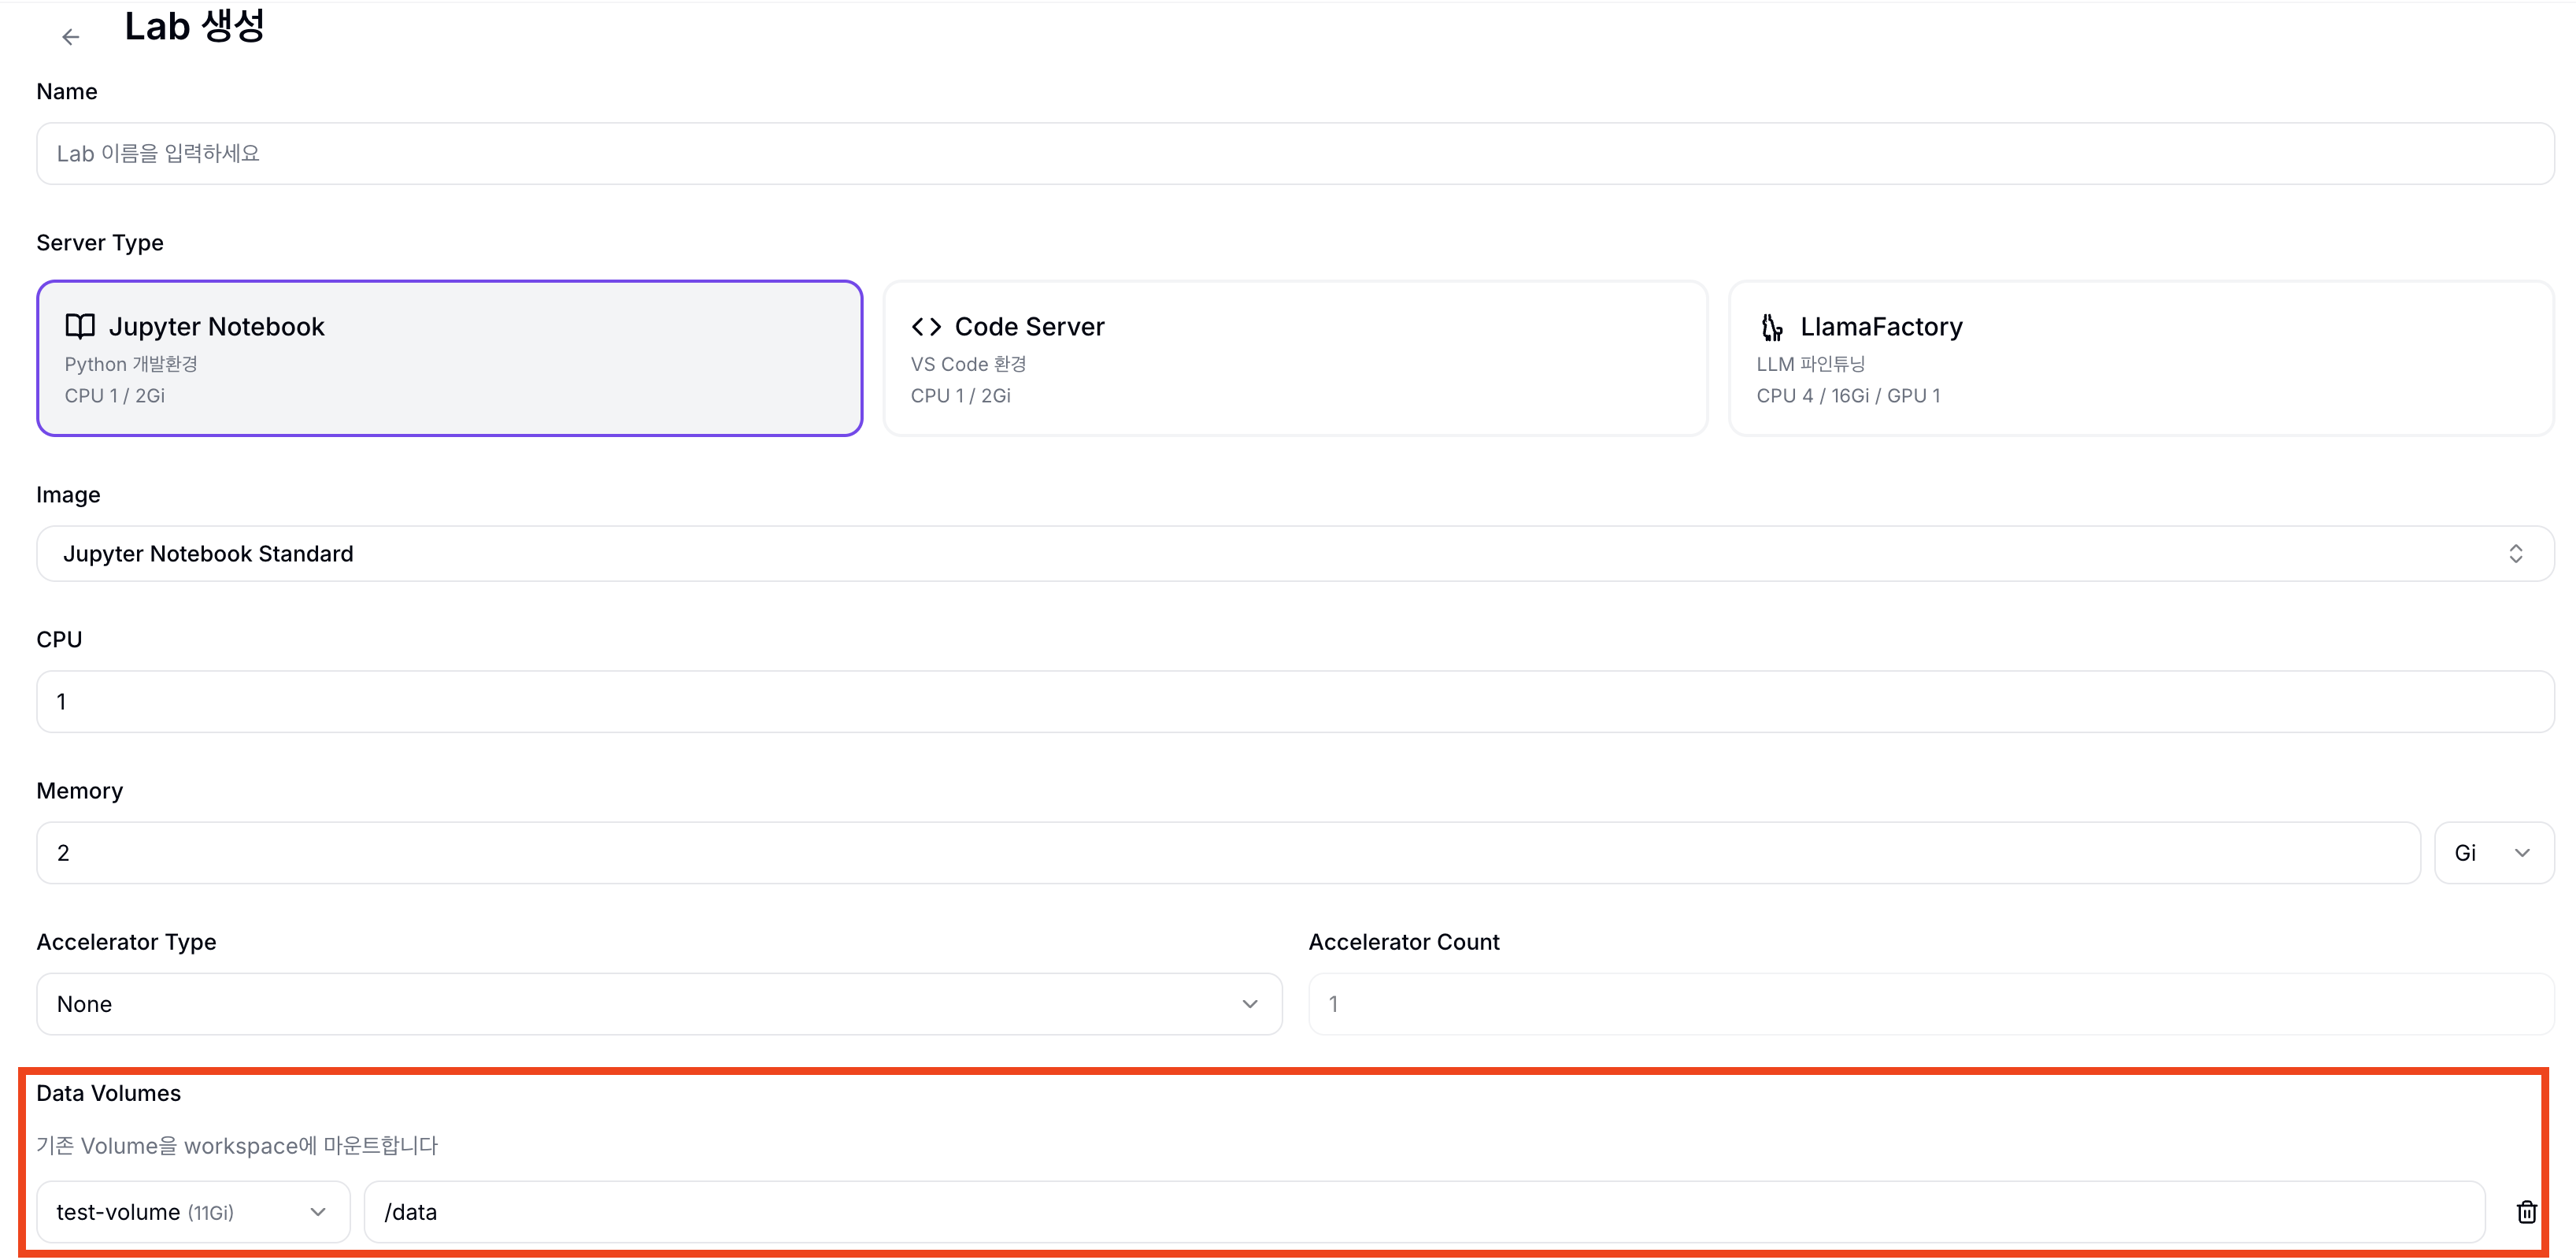
Lab 생성 시 Data Volumes에 모델 저장용 Volume을 추가하고 마운트 경로를 /data로 설정합니다.
| 필드 | 예시 값 |
|---|---|
| Name | tutorial-lab |
| Server Type | Jupyter |
| Data Volumes | tutorial-volume → /data |
2. 모델 다운로드
Lab이 Running 상태가 되면 Connect로 Jupyter에 접속합니다. File > New > Terminal에서 터미널을 열고 모델을 다운로드합니다.
pip install -U huggingface_hub

hf download Qwen/Qwen2.5-0.5B-Instruct \
  --local-dir /data/Qwen2.5-0.5B-Instruct
Private repository라면 먼저 token으로 로그인합니다.
hf login --token $HF_TOKEN
3. 모델 등록
좌측 사이드바에서 Model Artifacts를 클릭하고 Register Model을 실행합니다.
| 필드 | 예시 값 |
|---|---|
| Model Name | qwen-instruct-tutorial |
| Version | v1 |
| Volume | tutorial-volume |
| Path | Qwen2.5-0.5B-Instruct |
| Format | SafeTensors |
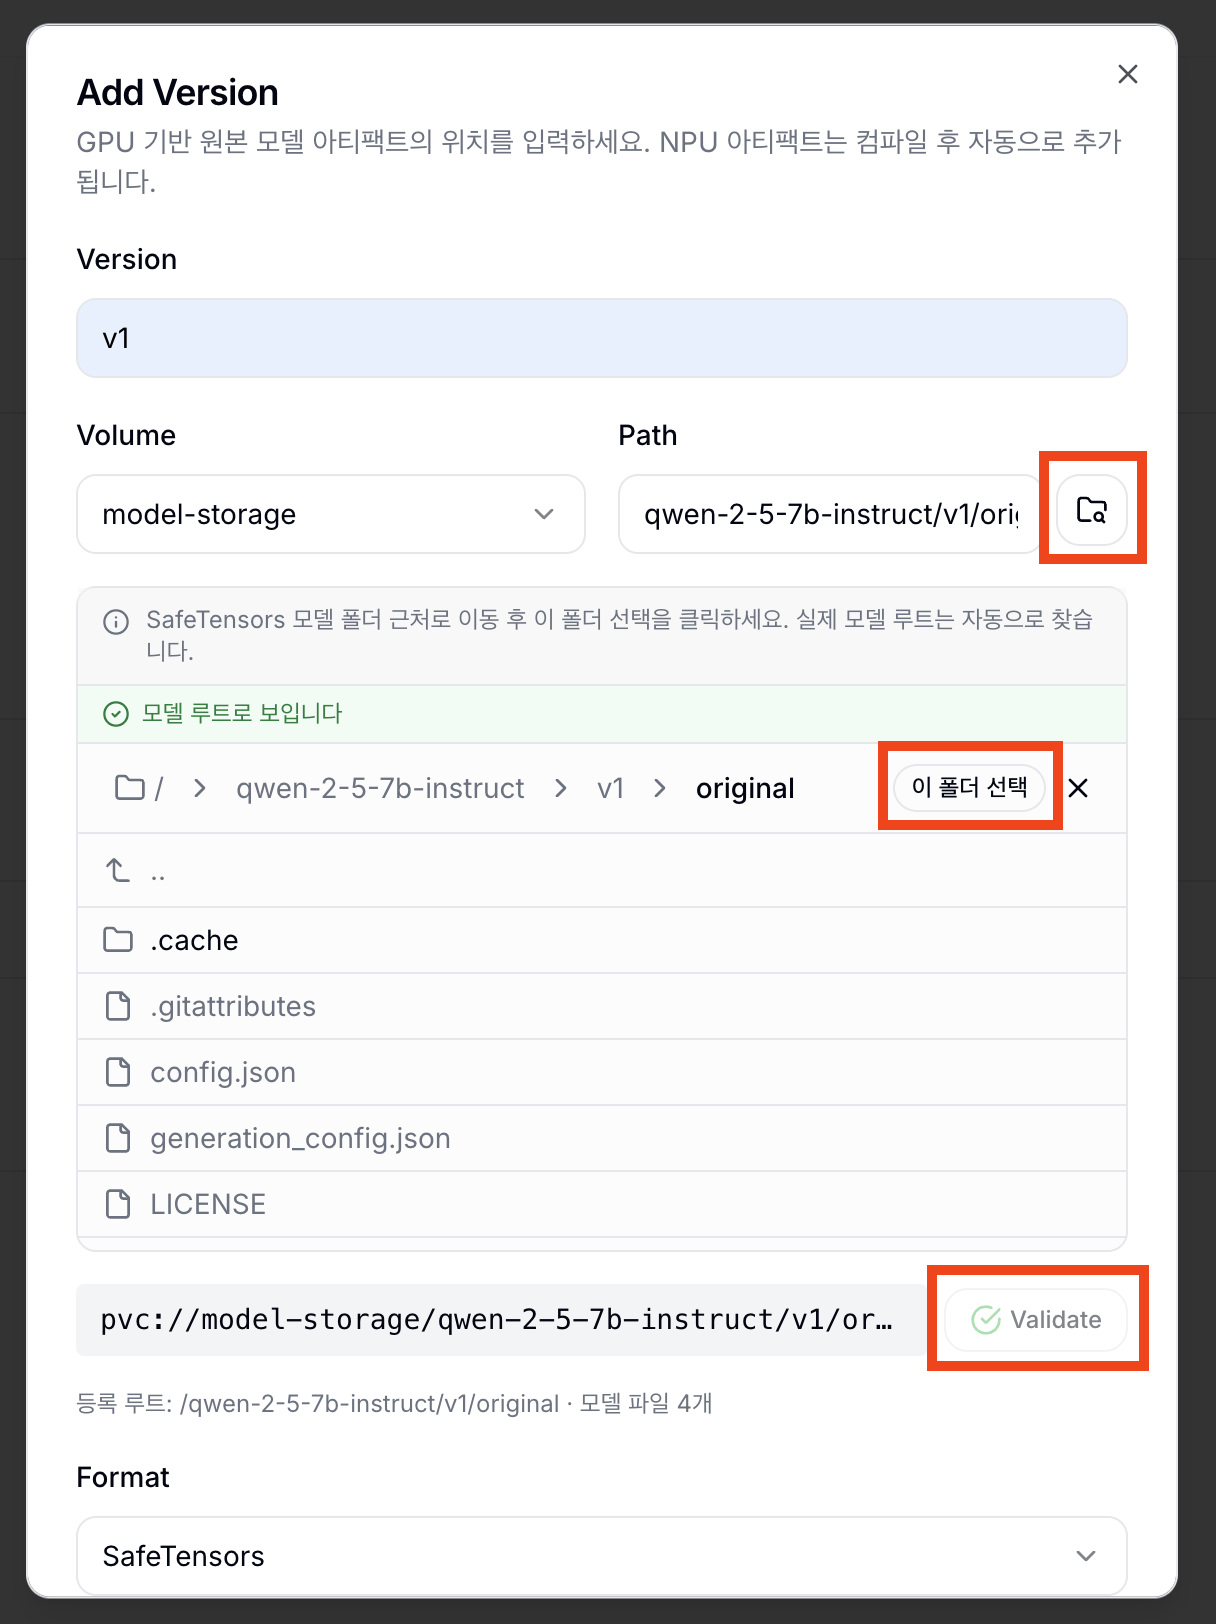
Validate가 성공하면 모델 버전을 등록합니다.
4. 서빙 방식 선택
GPU로 바로 서빙하려면 모델 상세에서 Quick Deploy를 실행합니다.
NPU로 서빙하려면 먼저 Model Compilations에서 원본 아티팩트를 컴파일합니다. 컴파일이 Succeeded가 되면 생성된 NPU 아티팩트로 Quick Deploy를 실행합니다.
5. Serving 생성
Quick Deploy 다이얼로그에서 배포할 모델, 버전, 아티팩트를 확인하고 Serving 이름을 입력합니다.
| 필드 | 예시 값 |
|---|---|
| Service Name | lab-downloaded-model-serving |
| Version | v1 |
| Artifact | GPU 서빙은 원본 아티팩트, NPU 서빙은 컴파일된 아티팩트 |
Serving 목록에서 상태가 Running으로 바뀌면 배포가 완료된 것입니다.
다음 단계
서빙 모델의 응답을 확인하려면 Playground에서 응답 테스트하기를 진행하세요.
디바이스 및 노드 메트릭을 확인하려면 Monitoring에서 지표 확인하기를 진행하세요.